『도메인 주도 개발 시작하기 - DDD 핵심 개념 정리부터 구현까지』를 읽고 정리한 내용입니다.
리포지터리
리포지터리는 애그리거트 단위로 조회하고 저장하는 역할을 담당한다.
애그리거트는 하나의 도메인 모델 단위이기 때문에 리포지터리 역시 일반적으로 애그리거트 단위로 존재한다.
위치
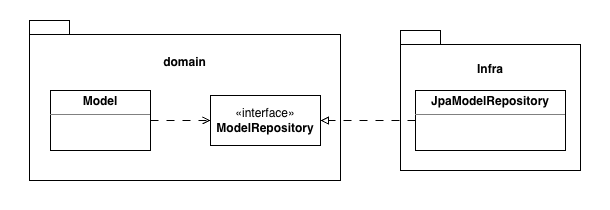
리포지터리는 인터페이스와 구현체를 분리하여 구성한다.
- 리포지터리 인터페이스 → 도메인 영역
- 리포지터리 구현체 → 인프라 영역
NOTE
도메인 영역은 리포지터리 인터페이스만 알고, 구체적인 구현체는 인프라 영역에서 제공한다.
이를 통해 도메인 영역과 데이터베이스, JPA 등의 구현 기술을 분리할 수 있다.
이러한 구조를 사용하면 도메인 영역은 특정 저장 기술에 직접 의존하지 않고, 필요한 기능을 추상화된 인터페이스를 통해 사용할 수 있다.
애그리거트 로딩 전략
애그리거트는 사용하는 시점에 필요한 상태를 갖추고 있어야 한다.
예를 들어 Product가 애그리거트 루트이고 내부에 여러 객체가 포함되어 있다면, 상태를 변경하는 시점에는 필요한 객체가 정상적으로 로딩되어 있어야 한다.
// 애그리거트 루트인 Product에 속한 모든 객체가 완전한 상태여야 한다.
Product product = productRepository.findById(productId);
즉시 로딩(EAGER)
즉시 로딩은 애그리거트에 포함된 연관 객체를 함께 조회하여 애그리거트를 한 번에 구성하는 방식이다.
애그리거트 전체를 한 번에 조회할 수 있다는 장점이 있지만, 연관된 객체가 많아질수록 조회 비용이 증가할 수 있다.
문제점
즉시 로딩을 무조건 사용하면 다음과 같은 문제가 발생할 수 있다.
- 조인이 증가한다.
- 여러 컬렉션을 함께 조회할 경우 카테시안 곱(Cartesian Product)이 발생할 수 있다.
- 불필요한 데이터까지 조회하여 조회 성능이 저하될 수 있다.
NOTE
애그리거트는 개념적으로 하나의 단위이지만, 항상 모든 객체를 한 번에 로딩해야 하는 것은 아니다.
애그리거트의 모든 객체를 항상 조회해야 하는 것은 아니므로, 실제 사용 목적과 조회 상황을 고려하여 로딩 전략을 결정해야 한다.
언제 완전한 상태가 필요한가?
애그리거트의 완전한 상태가 필요한 대표적인 경우는 다음과 같다.
- 애그리거트의 상태를 변경하는 경우
- 애그리거트 전체를 화면에 표시해야 하는 경우
반면 단순히 특정 데이터를 조회하기 위한 경우라면 애그리거트 전체를 로딩하는 것이 비효율적일 수 있다.
이러한 경우에는 조회 전용 모델을 별도로 구성하는 CQRS 방식을 사용하는 것이 더 적합할 수 있다.
애그리거트의 영속성
애그리거트는 하나의 단위로 저장하고 삭제하는 것을 기본으로 한다.
예를 들어 다음과 같은 Order 애그리거트가 있다고 가정한다.
Order (Root)
 ├── OrderItem
 ├── Delivery
└── PaymentOrder가 애그리거트 루트이므로 애그리거트 내부 객체 역시 Order의 생명주기에 맞춰 관리한다.
따라서 Order를 저장하거나 삭제할 때 필요한 경우 내부 객체도 함께 영속화하거나 삭제할 수 있다.
이러한 처리는 JPA의 Cascade와 같은 기능을 활용할 수 있다.
또한 애그리거트의 변경은 하나의 트랜잭션으로 처리하여 애그리거트 내부의 일관성을 유지하는 것이 중요하다.
즉, 애그리거트 내부의 객체들이 서로 다른 시점에 저장되어 일관성이 깨지는 상황을 방지해야 한다.
식별자 생성
애그리거트나 Entity를 식별하기 위해서는 고유한 식별자가 필요하다.
식별자는 여러 가지 방식으로 생성할 수 있다.
생성 방식
대표적인 식별자 생성 방식은 다음과 같다.
- 사용자가 직접 생성한다.
- 도메인 로직에서 생성한다.
- 데이터베이스가 자동으로 생성한다.
데이터베이스에서 자동으로 생성하는 방식에는 AUTO_INCREMENT, SEQUENCE 등이 있다.
DB 자동 생성
DB가 식별자를 생성하는 경우 일반적으로 다음과 같은 흐름으로 처리된다.
객체 생성
    │
    ▼
id 없음
    │
    ▼
INSERT
    │
    ▼
id 생성
이 방식에서는 객체를 생성하는 시점에 식별자가 존재하지 않을 수 있다.
데이터베이스가 INSERT 과정에서 식별자를 생성하기 때문에 저장 이후에 생성된 ID를 획득할 수 있다.
JPA와 DIP
DDD에서는 고수준 모듈이 저수준 모듈에 직접 의존하지 않도록 DIP(Dependency Inversion Principle)를 적용하는 것을 지향한다.
하지만 JPA를 사용하는 실제 애플리케이션에서는 DIP를 완전히 지키기 어려운 경우가 있다.
이유
JPA를 사용하면 도메인 객체인 Entity에 JPA 관련 애너테이션을 사용하게 된다.
@Entity
@Table
@Id
@Column
이러한 애너테이션을 사용하면 도메인 모델이 JPA라는 특정 구현 기술에 의존하게 된다.
또한 Repository 역시 Spring Data JPA 등을 사용하면서 특정 기술에 의존할 수 있다.
Domain
   │
   ▼
JPA Annotation
   │
   ▼
Infrastructure Technology
즉, 이상적으로는 도메인 영역이 구현 기술과 완전히 분리되어야 하지만, JPA를 사용하는 경우에는 일정 부분 기술적인 의존성이 발생한다.
NOTE
DDD에서는 DIP를 지향하지만, 실무에서는 생산성과 유지보수를 고려하여 JPA에 일부 의존하는 타협을 선택하는 경우가 많다.
중요한 것은 모든 기술적 의존성을 무조건 제거하는 것이 아니라, 도메인 로직과 구현 기술의 결합을 어느 수준까지 허용할 것인지 판단하는 것이다.
특히 JPA 애너테이션과 같은 기술적 요소는 도메인 모델에 포함될 수 있지만, 핵심 비즈니스 로직까지 JPA에 강하게 의존하지 않도록 설계하는 것이 중요하다.
정리
리포지터리는 애그리거트 단위의 조회와 저장을 담당하는 객체이며, 일반적으로 인터페이스는 도메인 영역에 두고 구현체는 인프라 영역에서 제공한다.
애그리거트는 사용 목적에 따라 필요한 상태를 갖추어야 하며, 항상 모든 내부 객체를 한 번에 조회해야 하는 것은 아니다. 특히 조회 목적이라면 조회 전용 모델을 사용하는 것이 더 적합할 수 있다.
또한 애그리거트는 하나의 단위로 영속화하고 트랜잭션을 통해 일관성을 유지하는 것이 중요하다. 식별자는 직접 생성하거나 도메인 로직 또는 데이터베이스를 통해 생성할 수 있다.
마지막으로 DDD에서는 DIP를 통해 도메인과 구현 기술을 분리하는 것을 지향하지만, 실무에서는 JPA와 같은 기술의 생산성과 편의성을 고려하여 일정 수준의 의존성을 허용하는 경우가 많다.
결국 중요한 것은 특정 원칙을 무조건적으로 적용하는 것이 아니라, 도메인의 핵심 비즈니스 로직을 보호하면서도 프로젝트의 생산성과 유지보수성을 고려하여 적절한 수준의 기술적 의존성을 선택하는 것이다.